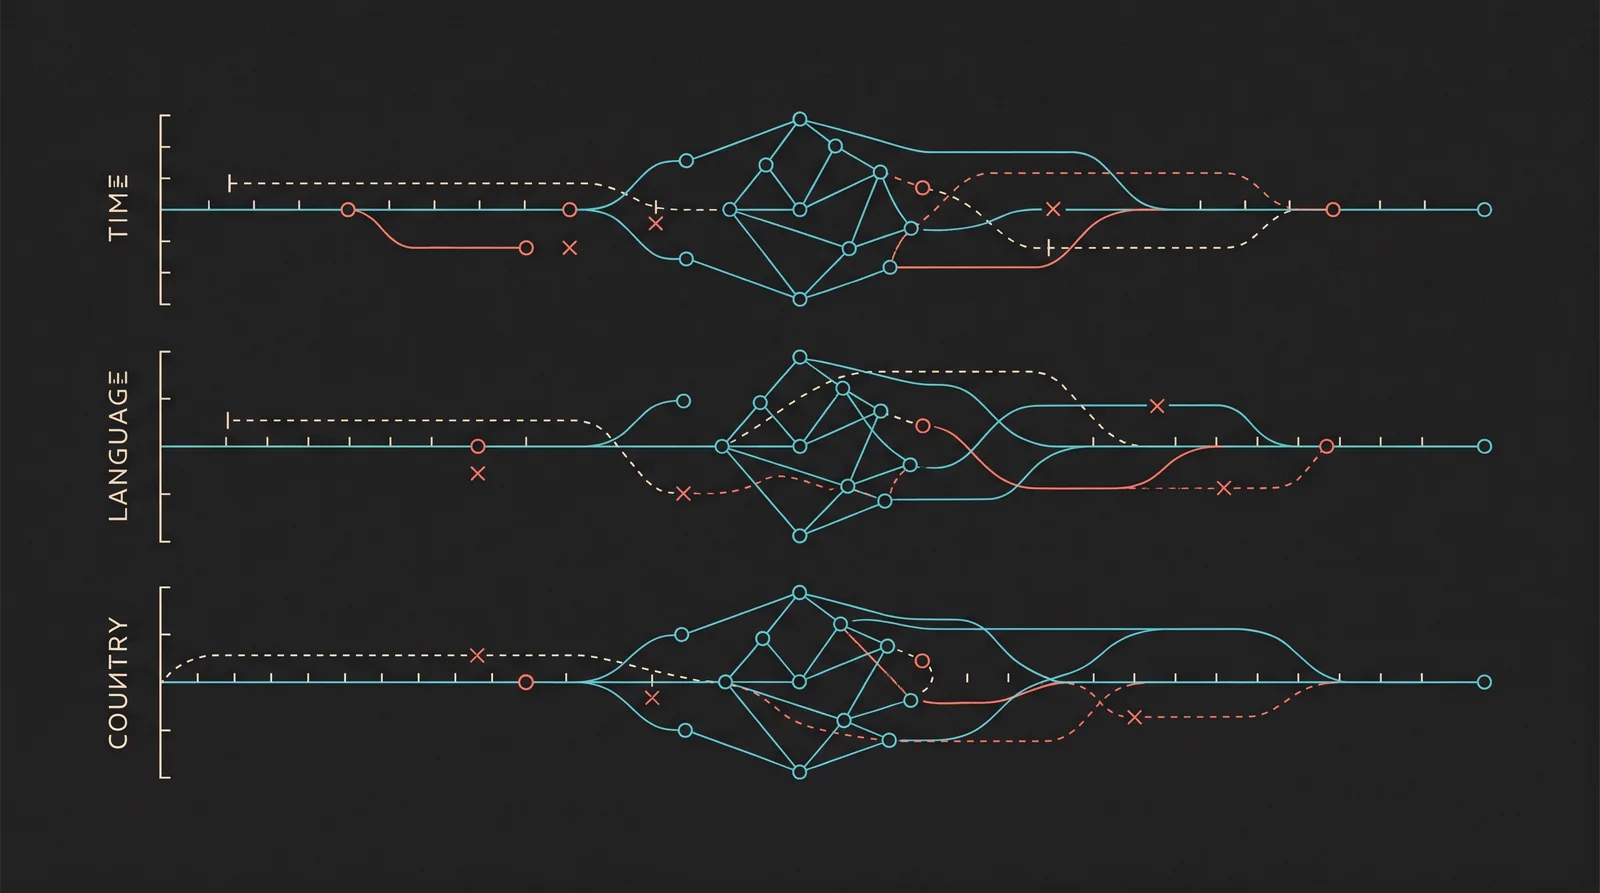
Warum ändern sich AI-Fanout-Ergebnisse?
Modellupdates, Zeitpunkt, Sprache, Land, verfügbare Webseiten, Provider-Routing und normale Generierungsvarianz können das Ergebnis ändern. Ein Lauf ist eine Beobachtung, keine dauerhafte Karte.
Lies das vor Providervergleichen oder Screenshots aus verschiedenen Tagen.
Erstelle einen datierten VergleichFühre dasselbe kurze Thema erneut aus, ändere kontrolliert Modell, Land oder Sprache und speichere beide Ergebnisse lokal.Erste Beobachtung startenZwei datierte Läufe zeigen eine Abweichung
Unser freigegebenes Beispiel verwendet best-seo-tools-us und best-seo-tools-repeat aus dem OpenAI-Korpus vom 27. August 2026. Die Zeitpunkte sind 13:13:23.681 UTC und 13:13:45.771 UTC. Beide dokumentieren dieselbe Eingabe best SEO tools, Sprache en, Land US und Modellbezeichnung gpt-5.6-luna. Beide stehen auf incomplete.
Für den nächsten Schritt nutze das Wiederholungsprotokoll mit Laufjournal.
Jeder Lauf enthält vier sichtbare Query-Strings und eine Suchaktion. Nach NFKC-Normalisierung, Entfernen äußerer Leerzeichen und Kleinschreibung stimmt genau ein String überein: Semrush SEO toolkit official features pricing. Die übrigen exakten Strings unterscheiden sich. Das ist eine Mengenüberschneidung nach dieser Regel, keine Bewertung semantischer Abdeckung.
Die normalisierten Domainsets enthalten elf beziehungsweise zehn Einträge. Ein Domainset ist weder eine Rangliste noch eine Liste eindeutig zugeordneter Query-Quellen. Zusammen mit den Strings belegt es eine Abweichung dieser beiden gespeicherten Beobachtungen; es erklärt nicht, welcher Einfluss sie verursacht hat.
Gleich dokumentierte Felder isolieren noch keine Ursache
Die Matrix führt Eingabe, Locale, Modellbezeichnung, Werkzeugversion, Zeit, Status, Queries und Quellen getrennt. Gleiche Labels bestätigen nur diese gespeicherten Metadaten. Sie beweisen keine unveränderte interne Modellbereitstellung, Suchindex-Version oder identische Provider-Routing-Entscheidung.
Zwischen den Beobachtungen liegen rund 22 Sekunden. Dieser Zeitabstand ist bekannt; ein Zeiteffekt ist damit nicht isoliert. Ebenso möglich bleiben Unterschiede in der Generierung, im Suchrouting oder im verfügbaren Kontext. Zwei unvollständige Läufe liefern weder einen universellen Stabilitätswert noch eine belastbare Ursache für wechselnde Suchzweige.
Land und Sprache können Suchkontext verändern. Um sie gezielt zu untersuchen, ändere nur das untersuchte Feld und wiederhole unter dokumentierten Bedingungen. Auch dann bleiben nicht beobachtbare Einflüsse offen. Der vorhandene Länderfall ist ein eigener Datensatz und kein Beweis, dass jede Abweichung zwischen zwei Ländern vom Land verursacht wurde.
Die Grenzen zeigt das datierte Länderbeispiel.
Eine Wiederholung auf eine konkrete Entscheidung begrenzen
Schreibe vor dem nächsten Lauf auf, was du herausfinden möchtest. Für einen Inhaltsabschnitt kann die Frage lauten: Tauchen Nutzerkosten wiederholt als Rechercheaufgabe auf? Für einen Parser lautet sie anders: Bleiben die sichtbaren Strings und Statusfelder korrekt erhalten? Diese Aufgaben brauchen verschiedene Abnahmen und sollten nicht in einem pauschalen Stabilitätsscore verschwinden.
Halte Eingabe, Locale, Provider, Modelllabel und öffentliche Tool-Version fest. Trenne vollständige, unvollständige, fehlgeschlagene und abgeschlossene Null-Beobachtungen. Ein Fehler ist keine erfolgreiche Beobachtung mit null Queries. Notiere auch, welche Felder nicht geliefert oder vor dem Speichern entfernt wurden.
Für den nächsten Schritt nutze die Berichtsvorlage.
Ein weiterer Lauf lohnt sich, wenn sein möglicher Befund deine nächste Aufgabe ändern würde. Ein Preisabschnitt braucht oft zuerst eine aktuelle offizielle Quelle, keine zehnte Fanout-Wiederholung. Für einen berichteten Vergleich übernimm die Kontrollmatrix und die offenen Ursachen zusammen mit den Ergebnissen.
Für den nächsten Schritt nutze das ausgefüllte Vergleichsbeispiel.
Häufige Fragen
Diese kurzen Antworten bündeln wiederkehrende Fragen aus Tool-Nutzung und Quellenprüfung. Sie sind keine behaupteten Suchvolumen-Daten.
- Warum kann dieselbe Eingabe Sekunden oder Tage später abweichen?
- Suchindizes, Modellversionen, Tool-Routing und verfügbare Quellen können sich ändern. Eine Wiederholung ist deshalb eine Beobachtung und kein Beweis für eine dauerhafte Provider-Regel.
- Welche Angaben müssen bei einer Wiederholung gleich bleiben?
- Halte exakte Eingabe, Anbieter, Modell, Land, Sprache und Tool-Einstellungen konstant. Notiere Zeitpunkt und Laufstatus, damit spätere Unterschiede ehrlich eingeordnet werden können.
Verwendete Quellen
Diese Quellen stützen die beschriebenen Funktionen und Grenzen. Sie belegen keine darüber hinausgehenden Aussagen.
- Eigene annotierte Abläufe, Kontrollen, Prompts und ExportübungenQuelle öffnen
Eigene Grafiken und redaktionelle Annotationen nutzen nur bereits freigegebene OpenAI-Daten. Synthetische Dateien stammen aus tatsächlichen Exportfunktionen und wurden unabhängig zurückgelesen; kein Provider-Aufruf oder Excel-/Sheets-Import. Die datierte eigene Seitenprüfung belegt weder Indexierung noch Wirkung.
- NIST AI RMF Generative AI ProfileQuelle öffnen
Supports explicit measurement, documentation, monitoring and limitations for generative-AI evaluations.
- OpenAI web search tool guideQuelle öffnen
Documents web_search_call output and search actions that usually, but not always, include the query or queries searched. Search actions, exposed strings and cited sources therefore need separate interpretation. It does not expose chain of thought or guarantee that every route returns query strings. Rechecked for the original 2026-10-10 zero-query decision table; no new provider observation is published.
- Gemini grounding with Google SearchQuelle öffnen
Documents Gemini 3.7 Flash Google Search, google_search_call arguments.queries, cited URL annotations and per-query billing.
- Dated OpenAI fanout example observationsQuelle öffnen
Four owner-run OpenAI API observations record exact inputs, timestamps, exposed query strings, search-action source domains, usage, method versions and response status. Versioned JSON, normalized CSV and a JSON Schema are published. They are not an independent benchmark.